
Step 1:基于 Transformer架构 的环境初始化与依赖管理
通过标准化依赖安装、核心模块加载、推理管线优化与行业场景集成四步,开发者可快速将 Transformer架构 部署至实际业务。
Transformer架构是指一种基于自注意力机制的深度学习模型设计范式,通过并行计算取代传统循环结构以处理序列数据。在正式编码前,需确保底层算力支持与服务链路畅通。工程师应优先排除底层驱动冲突,避免框架版本不匹配引发运行时崩溃。
- 系统环境核对:确认 Linux 或 Windows 环境下 CUDA 11.8+ 或 ROCm 版本匹配,Python 锁定 3.9-3.11 区间以保证算子兼容性。
- 核心库安装:执行 pip install torch transformers accelerate 获取官方基座,同步配置 HF_HUB_CACHE 环境变量指定本地缓存路径,节省网络带宽。
- 依赖隔离:强烈建议使用 Conda 或 venv 创建独立沙箱,隔离旧版 NumPy 与 SciPy,防止线性代数库版本漂移导致张量运算溢出。
完成基础配置后,可进入模型权重下载环节。推荐使用 hf_transfer 加速下载,并通过校验和脚本验证文件完整性,防止中途断点续传引发梯度损坏。
Step 2:构建 Transformer架构 的核心计算图与权重加载
模型加载并非简单读取文件,而是涉及动态图编译与参数映射的工程过程。一线开发者需掌握权重分片策略以降低显存峰值,确保硬件资源利用率最大化。
- 设备映射:利用 device_map=auto 实现多 GPU 自动分配,配合 max_memory 参数严格划定每张卡的显存边界,防止 OOM 中断进程。
- 精度降维:针对推理场景开启 torch.float16 或 bitsandbytes 的 nf4 量化。需特别注意检查 LayerNorm 层的数值稳定性,必要时手动校准激活值分布。
- 算子替换:将默认 Attention 头切换为 FlashAttention-2,通过共享内存直接读写 SRAM 减少全局带宽占用。实测序列长度超过 8k 时,吞吐提升约 40%。
权重加载完成后,必须执行前向传播探测。输入标准测试 Token 序列,记录 attention_mask 与 position_ids 的维度对齐状态,确保因果掩码未出现越界索引。若日志报错 device-side assert triggered,通常源于位置编码超出最大长度阈值,需调整 config 中的 max_position_embeddings 字段。
Step 3:优化 Transformer架构 的推理管线与内存控制
高并发请求下,静态批处理与 KV Cache 复用是维持低延迟的关键。本节聚焦管线流水线的设计与显存碎片整理,旨在突破物理显存瓶颈。
- 动态批处理配置:设置 batch_size 上限与 max_new_tokens 限制,启用 DynamicCache 替代传统固定数组,根据实际生成长度按需分配连续内存块。
- 钩子函数挂载:注册 register_forward_hook 捕获中间层 Tensor,用于自定义早停逻辑或幻觉检测。该方式无需侵入原始源码,便于后续迭代维护。
- 显存清理策略:每处理完一个微批次,调用 torch.cuda.empty_cache() 并强制触发垃圾回收。重点防范 Python 引用计数循环导致的句柄泄漏累积。
性能调优需结合 PyTorch Profiler 工具定位瓶颈。优先压缩序列维度,其次优化矩阵乘法核。对比纯 CPU 推理方案,GPU 加速在 Batch Size 大于 4 时优势显著,但需注意 PCIe 传输延迟对首字延迟(TTFT)的负面冲击。
Step 4:实现 Transformer架构 的行业场景集成与测试验证
将模型接入业务流需解决协议转换、异步调用与监控告警三大难题。工程化落地高度依赖标准化的服务封装与严格的边界测试。
- API 网关封装:使用 FastAPI 或 Triton Inference Server 暴露 REST 与 gRPC 接口,统一处理 JSON 序列化、鉴权中间件与跨域安全校验。
- 异步任务队列:引入 Celery 或 Redis Queue 承接长文本生成请求,设置超时重试机制与结果持久化存储,避免阻塞主线程导致服务雪崩。
- 灰度发布流程:采用蓝绿部署策略,先切分 5% 流量至新实例,监控 P99 延迟与每秒 Token 生成量,各项指标达标后再执行全量切换。
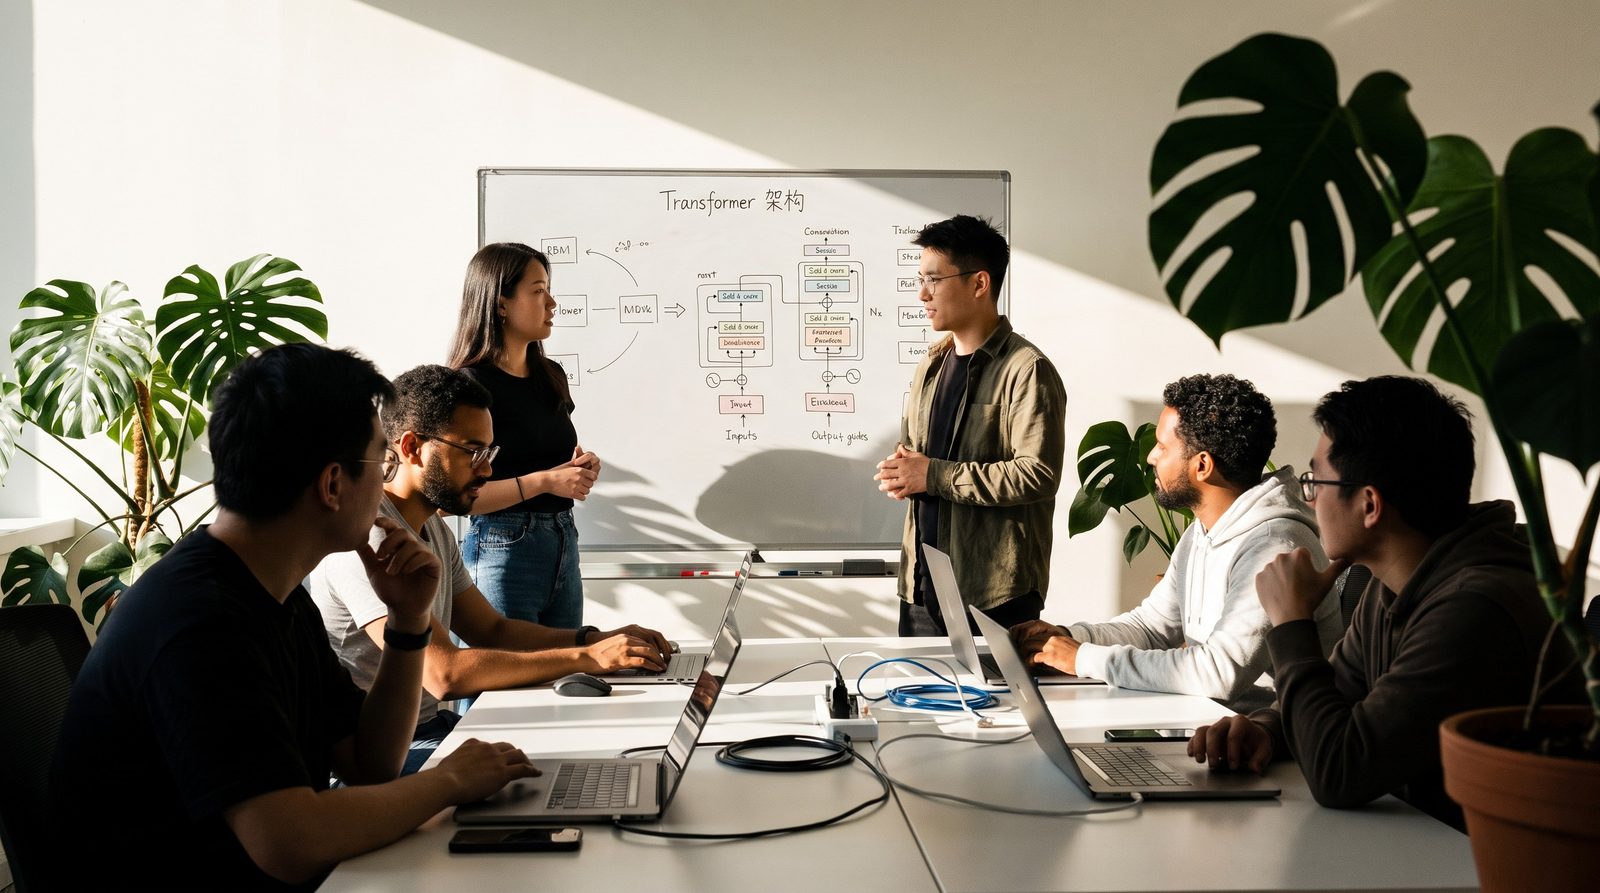
测试验证阶段应覆盖基准数据集与真实脏数据。重点评估 Rouge 分数与损失曲线收敛态的同时,主动注入乱码、超长上下文与敏感词触发边界条件。记录失败用例并反向修正 Prompt 模板或 Temperature 参数,确保输出符合行业合规标准。
常见问题
如何解决长上下文导致的显存溢出?
启用分页注意力算法或稀疏注意力掩码,限制有效计算窗口范围,结合混合精度训练降低单序列内存开销,彻底释放显存压力。
微调时梯度消失应如何排查?
检查学习率是否过高或 Warmup 步数不足,解冻浅层参数进行分层学习率设置,并验证归一化层位置是否被错误覆盖或移除。
生产环境怎样平衡响应速度与生成质量?
采用蒸馏模型替代原生大参数版本,或引入投机解码技术,用轻量小模型辅助草稿生成,在不牺牲准确度的前提下显著提升整体吞吐。
总结与实践建议
从环境搭建到业务集成,完整工程链路已清晰呈现。一线开发者应坚持模块化设计,定期更新依赖库安全补丁。结合自动化测试与持续集成平台,可大幅降低长期维护成本。建议团队建立内部模型资产库,沉淀通用组件与调试脚本,推动工程规范标准化,加速下一代智能体应用的规模化落地。

